AI Mistral AI 推出 Timestral 系列:209M 参数零样本预测模型领跑业界 Mistral AI 发布首个时间序列基础模型系列 Timestral,涵盖 5M‑209M 参数四款零样本预测模型,在 GIFT‑Eval、TIME、fev‑bench 等权威基准上全线领先,并实现 CPU 零 GPU 推理,为企业和开发者提供高效、低成本的时序预测新选择。
AI AI 助力公关:Honeyjar 用智能工具提升企业传播效率 公关行业面临效率瓶颈,AI 初创公司 Honeyjar 通过自动化撰稿、媒体匹配等功能,让创始人和中小企业也能获得顶级公关专家的判断与技巧,帮助企业在信息噪声中脱颖而出。
AI AI 识别多猫进食习惯,Petlibro Granary 2 系列评测 Petlibro 推出的 Granary 2 系列智能喂食器,凭借内置称重、AI 摄像头和多猫识别功能,为多猫家庭提供精准的喂食和健康监控,帮助主人更好了解猫咪的饮食行为。
AI Meta推出Muse个人AI助手:消费者能否信任它? 在与美国监管机构达成18亿美元和解后,Meta紧接着发布了全新个人AI助手Muse,承诺帮助用户处理邮件、预订旅行、购物等日常事务。本文分析Muse的功能、数据安全挑战以及消费者信任的关键因素,帮助你快速了解这款新产品的价值与风险。
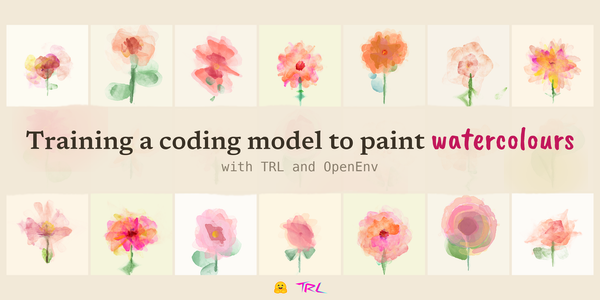
AI 用 TRL 与 OpenEnv 训练代码模型绘制水彩画 近日,Surya Narreddi 用 JavaScript 与 p5.brush 让语言模型生成水彩画,引发热议。本文梳理其技术路线,展示如何在 Hugging Face 上利用 TRL 与 OpenEnv 完整复现,从数据集、强化学习环境到评分模型,一站式实现 AI 绘画。
AI 揭秘 LLM 基准测试:BenchMIRT 如何剖析真实能力 近日 AllenAI 发布 BenchMIRT,提供对大型语言模型基准测试的细粒度审计方法。文章解析其工作原理、对 BBQ、WildJailbreak 等常用基准的重新解读,帮助研究者看清分数背后的真实能力。
AI Instinct 估值 25 亿美元:AI 个人助理的快速崛起 仅创立一年、创始人仅 23 岁的 Instinct 完成 3.5 亿美元融资,估值突破 25 亿美元。该公司推出的 AI 个人助理通过深度整合用户的应用和设备,帮助规划旅行、购物、订票乃至婚礼,备受早期用户好评,也引发隐私权限争议。
AI Linkdaze 智能日历:为全家打造的数字化时间管理中心 随着开学季来临,家庭成员的时间表愈发错综复杂。Linkdaze 通过多平台同步、颜色区分以及 AI 食谱规划等功能,将纸质日历的局限彻底打破,为家庭提供一站式的时间与事务管理解决方案。
AI DeepSeek Harness:全插件化的开源智能体框架 DeepSeek Harness(dsh)是一款由 DeepSeek AI 开源的智能体框架,采用“一切皆插件”的设计理念,基于 Cordis 实现时空可组合性。本文将从架构、快速上手、社区生态三方面详解其优势与使用方法,帮助开发者快速构建可扩展的 AI 应用。
AI 我们用 RealVuln 测试了 AI 代码扫描工具:召回率、精确率与误报对比 摘要(更新于 2026 年 7 月 20 日) :2026 年 6 月 17 日,我们拿 RealVuln 测了一遍 MonkeyScan,也记录了 Dee
AI AI 评测系列(02):评测指标设计——从业务目标到可量化指标 指标缺失时会发生什么 一个 RAG 问答系统上线了。工程师说"测试都通过了"——API 响应时间 < 2 秒,格式正确,没有崩溃。 两周后用户反馈说"AI
AI AI 评测系列(01):为什么 AI 评测难——不确定性、主观性与多维度 传统软件测试的假设 传统软件测试建立在三个假设上: 输出确定 :相同输入给相同输出,测试可以复现 正确性可判定 :函数返回 42 是对还是错,有明确标准 维
AI Claude Code 是什么?AI 编程命令行工具使用教程 Claude Code 是 Anthropic 推出的 AI 编程工具,能在终端里理解代码库、自动改代码。本文讲清它的用法与订阅支付。
AI AI 测试提效神器:推荐一款接口自动化测试提效skill! 导读 :前面我们已经分享过了,如何用 AI + Agent Skill 把接口测试脚本自动"造"了出来。但脚本生成只是起点——真正让接口自动化测试产生价值的